语言: English | 简体中文
本文是英文版
vignette("data-shield")的完整中文翻译,供内部讨论使用。概念定义、参数默认值以本文为准;如与代码有出入,以代码为准(两版会同步更新,但请以英文版 + 代码作为最终权威来源)。
状态 — P0/P0.5/P1/P1.5/C2/C5-policy 已实现;完整设计仍在推进。 egress 行数上限、受保护值精确匹配、严格
DescribeData、有序扫描器管道、 通用工具调用前置扫描、按工具策略、基于 promise 的 egress 审批、便携式 路径/符号链接沙箱、可选的脱敏代码语义审查器、以及 DP 加噪类别计数 (distributions="dp")均已接线完成。完整 OS 执行隔离适配器与数值/连续 统计量的差分隐私仍是路线图项。默认关闭(data_shield = NULL)。
为什么需要它
当 codeagent
作为后端接入敏感数据(临床、金融、PII)时,我们要的保证是:
LLM
可以看到元数据和描述性摘要,但绝不能看到原始行级数据。数据盾是一个
默认关闭、可插拔的安全阀(data_shield = NULL),开启时由若干独立策略组合而成。
核心:三条边
去掉 agent 的其他机制,数据会在三条边穿过模型边界。数据盾在每一条边上 都安装了 gate:
- 用户/模型输入(边 1,input gate)——用户输入的文本和含文本的附件在 模型看到之前先扫描。框架自行注入的受保护数据上下文则单独生成经过过滤的 schema-only 元数据(名称、类型、维度及策略允许的安全摘要),绝不包含原始行。
- 工具流量(边 2,tool gate)——工具参数在执行前检查,工具结果在回灌 模型前过滤。
- 模型最终回复(边 3,output gate)——完整回复在到达用户前扫描,因为 即使用户输入干净,模型也可能复述从边 2 聚合结果中推断出的受保护值。
RAG 内容、附件和错误都必须经过其中一条边。相同策略会递归应用于框架拥有的 前台子代理。
图片边界: prompt 中的图片附件默认不扫描。宿主可以选择接入 OCR hook (
data_shield_ocr_scanner()),扫描图片中烘焙的文字以保护边 1。图片/多模态 工具结果仍会绕过文本 egress 扫描,需要宿主另行提供图片结果控制。
技术架构一览
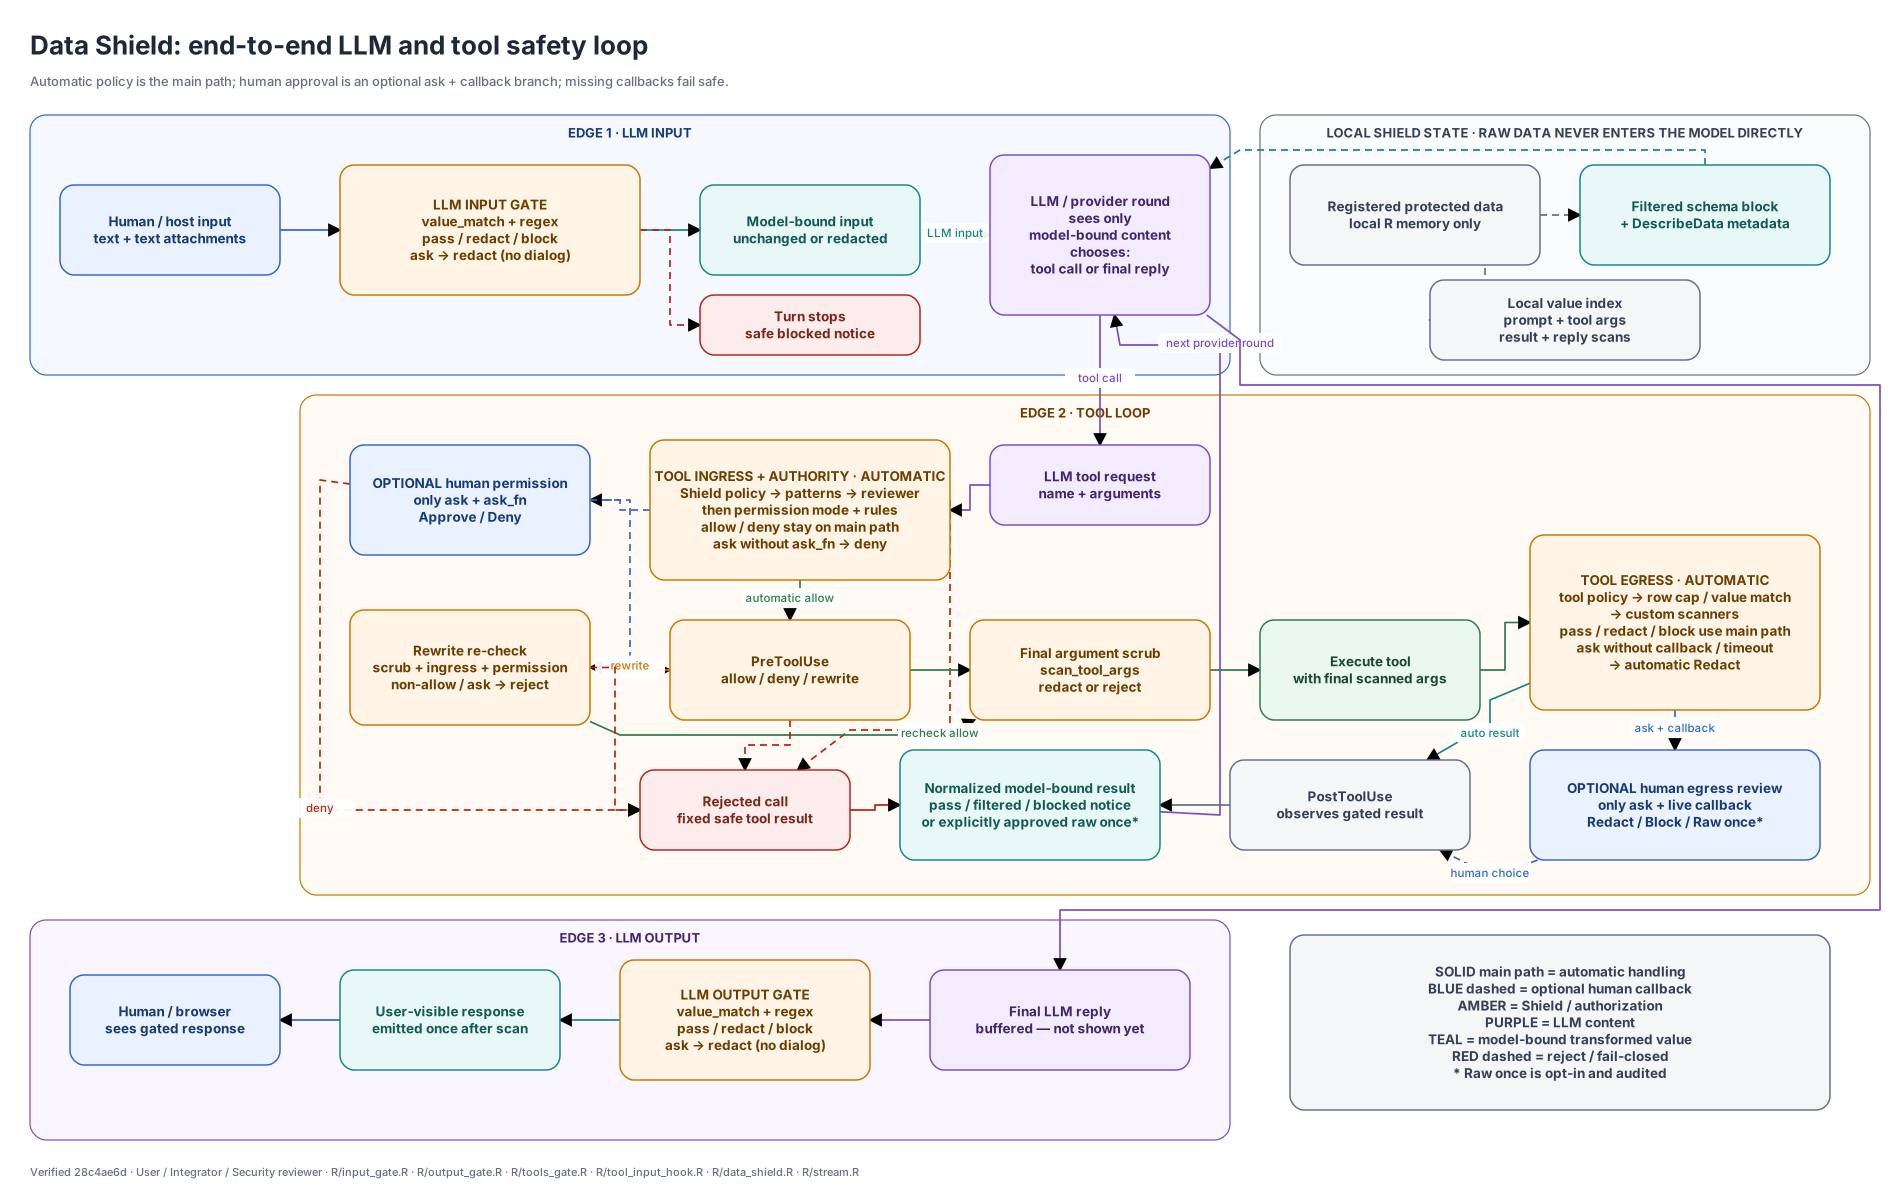
实线主干是自动流程。 蓝色虚线只在 ask
且存在宿主 callback 时进入人工 旁路;没有 callback 时,tool ingress 自动
deny、tool egress 自动 redact,input/ output 的 ask
也降级为 redact。红色虚线表示 reject 或 fail
closed。Raw once
必须显式启用并写入审计。中央权限门保持独立,Shield bypass
永远不会绕过权限检查。
下面每个代码片段共用的起手式
本文档里每个代码块都接着一个已经建好的 chat(一个裸的
ellmer Chat, 不是
CodeagentClient 包装器)和一个
shield(DataShield 实例)继续,
两者只在最前面建一次:
chat <- ellmer::chat_openai_compatible(
  base_url    = Sys.getenv("CODEAGENT_BASE_URL"),
  model       = Sys.getenv("CODEAGENT_MODEL"),
  credentials = function() Sys.getenv("CODEAGENT_API_KEY"))
shield <- DataShield$new()
codeagent_client(chat, ...) 不会拷贝
chat——client$chat 跟你传进去的
chat 是同一个对象(可变的
R6/环境语义),所以某个片段调用 chat$register_tool(...)
还是 client$chat$register_tool(...) 效果相同;
本文档统一用裸 chat 变量,图个简洁。
设计:可组合策略(不是固定模式)
data_shield 接受
NULL(关闭)、一个有序策略列表(会创建一个私有
DataShield R6), 或一个显式的 DataShield
实例(用于上传数据、有意在 session/thread 间共享)。
已实现的策略先展示;规划中的策略单独列出,以免示例暗示它们已经存在。
# 当前已实现:
client <- codeagent_client(chat, data_shield = list(
  shield_describe(k_anon = 5),
  shield_egress(detectors = c("row_cap", "value_match"),
                max_rows = 0, on_fail = "block"),
  shield_regex(on_fail = "redact"),
  shield_ingress(langs = c("r", "python", "bash"), on_fail = "ask"),
  shield_tool_policy(rules = list(
    KMPlot = list(ingress = "scan", egress = "bypass"),
    DangerousExport = list(execution = "deny")
  )),
  shield_sandbox(project_root = getwd(), backend = "policy"),
  shield_reviewer(model = Sys.getenv("CODEAGENT_FAST_MODEL"),
                  scope = c("exec", "write", "net"), on_risk = "ask")
))

# 路线图(尚未实现):
# shield_narrow_tools()主边界是边 2(工具结果);沙箱、ingress 黑名单、审查器、工具收窄都是纵深防御, 不是边界本身。
当前参数参考
data_shield 输入
| 值 | 效果 |
|---|---|
NULL |
完全关闭;codeagent 现有行为不变 |
list(shield_*()) |
codeagent 为该 client 创建一个私有 DataShield
R6;egress 扫描器按列表顺序运行,ingress/reviewer/sandbox/tool-policy
则在各自阶段运行 |
DataShield$new(...) |
显式生命周期,用于上传数据、在多个 chat 间有意共享 |
Input/output gate 与扫描器默认值
Input gate 和最终回复 gate 属于 client setting,不是
shield_*() 策略。安全默认值如下:
| Setting | 默认值 | 效果 |
|---|---|---|
data_shield_prompt_on_fail |
"redact" |
脱敏用户文本中的命中片段;"block" 拒绝整轮输入 |
data_shield_input_scanners |
c("value_match", "regex") |
扫描已注册受保护值和 PII/token 形状 |
data_shield_response_on_fail |
"redact" |
脱敏最终模型回复;"block" 用 blocked 提示替换回复 |
data_shield_output_scanners |
c("value_match", "regex") |
对最终回复应用相同的两个检测器 |
data_shield_image_scanner |
NULL |
除非宿主提供 hook,否则不扫描图片 |
未知扫描器名称和扫描器异常都会 fail closed。输入侧 "ask"
没有独立审批
通道,会降级为脱敏。含文本附件会被扫描;如果无法提取其文本,本轮会被拦截,
因为不可变附件无法安全地原地改写。盾开启时,CLI 和 Shiny
流式路径会先缓冲
完整模型回复、完成扫描,再一次性发送安全文本——不会先流出明文再告警。
Prompt 图片可这样选择启用 OCR:
client$settings$data_shield_image_scanner <-
  data_shield_ocr_scanner(client$data_shield)
tesseract 是可选依赖。没有安装时,现成的 scanner
会降级为 pass(图片盲区 仍存在)。一旦 OCR 可用且 scanner
已配置,图片不可读、OCR 出错、OCR 文本 扫描出错都会
block;检测到受保护文字时默认也会 block。
shield_egress() —— 核心的工具结果边界
| 参数 | 默认值 | 实际效果 |
|---|---|---|
detectors |
c("row_cap", "value_match") |
row_cap 挡整批表格输出;value_match
挡已索引的高熵值 |
max_rows |
0 |
命中整批/表格状输出时,保留 0 行原始打印内容,只返回一句
withheld/blocked 提示。设为 5 会故意暴露前 5 行 |
on_fail |
"redact" |
redact:withheld 提示;block:blocked
提示;ask:交给 LLM 前先暂停 |
allow_raw_approval |
FALSE |
询问时默认只显示 Redact/Block;设 TRUE 会加一个危险的”Raw once”选项 |
approval_timeout |
60 |
异步场景下多少秒后自动 redact |
max_rows = 0 不会泛化地拦所有
print()。print(nrow(df))、状态消息、
模型摘要、图表、错误信息都会放行,除非其他检测器命中敏感内容。只有输出具备
data.frame/tibble 打印签名或多行矩形表格外观时才会触发。
on_fail="ask" 时,原始结果留在本地,回调/UI 只收到 tool
名/id、策略、原因标签、 命中数、分数、超时时间、以及是否启用了
raw-once。无回调、报错、非法选择、ESC、 超时的默认安全动作都是
redact。Raw-once 只对本次结果生效,且会被审计。
shield_describe() —— 严格的模型安全元数据
| 参数 | 默认值 | 实际效果 |
|---|---|---|
distributions |
"off" |
"off":不给计数,只给类别标签。"on":真实类别计数(无隐私保护)。"dp":Laplace
加噪的类别计数,从每个 dataset 的 dp_budget 里扣
dp_epsilon;预算耗尽后降级为 "off"
式的纯标签输出。数值/日期/logical/自由文本列在三种模式下行为完全不变——见下文 |
k_anon |
5 |
支持行数少于 k 的类别标签会变成
<rare suppressed>(三种 distributions
模式下都适用,计数是在这一步之后才加的) |
category_max |
20 |
判定为分类处理的最大字符值去重数 |
category_ratio |
0.2 |
判定为字符分类处理的最大去重/非缺失比率 |
dp_epsilon |
1 |
"dp" 模式下,每次 describe()/schema-block
调用里每个暴露计数的分类列收取的隐私成本,在该列存活类别间均分。只在
"dp" 下有意义 |
dp_budget |
5 |
"dp" 模式下每个 dataset 的总 epsilon
预算——一次性额度,不做时间窗口重置。只在 "dp" 下有意义 |
敏感度仍然钳制输出:identifier/quasi
值始终被抑制;measure/open 可能给 数值/日期的
min-max 和安全的类别标签,"on"/"dp"
下会附加计数。
v1
范围边界:只有分类列会得到计数。数值列(mean/sum/分位数等)不在本轮范围
内——对连续统计量做差分隐私需要一个”裁剪边界”来算噪声强度,而这个边界不能从
真实数据自己的 min/max
直接算(那样等于用私有信息定义隐私保护的强度,是已知的 DP
陷阱)。在宿主能提供真实的、不依赖数据本身的边界之前,range=[min, max]
在三种 distributions 模式下保持不变。logical
列和自由文本列同理不变。
进展跟踪:references/plan/31x-dp-distributions.TODO.md。
某个 dataset 的 dp_budget 耗尽是静默且永久的(直到该
dataset 重新注册为止): 不报错、不给真实计数,只是悄悄退回
"off" 式的纯标签输出。调用
shield$dp_budget_remaining(name)(不传参数则返回所有已注册
dataset 的具名
向量)查看剩余预算,供宿主端展示”隐私预算:2/5”之类的提示。每次消耗/耗尽都会
记进审计日志(strategy = "dp_budget")。
dp_metadata <- shield_describe(distributions = "dp", dp_epsilon = 1, dp_budget = 5)
shield <- DataShield$new(strategies = list(dp_metadata))
shield$register_data(df, name = "study")
shield$describe("study")             # 如果 "arm" 是分类列,花掉 1 epsilon
shield$dp_budget_remaining("study")  # 4
shield_regex() —— 未注册的 PII/密钥
| 参数 | 默认值 | 实际效果 |
|---|---|---|
patterns |
NULL |
可选的具名正则规则,使用 PCRE 语法,例如
c(study_id = "STUDY-[0-9]+");开启时追加到默认规则 |
include_defaults |
TRUE |
email、类电话号码、常见 token 前缀、18 位身份证号规则 |
replacement |
"[REDACTED]" |
每个合并后的命中片段插入一次的标记 |
on_fail |
"redact" |
redact:保留安全的周边文本;block:替换整个结果 |
ignore_case |
TRUE |
所有规则大小写不敏感 |
shield_ingress() —— 每次工具调用执行前先扫描
| 参数 | 默认值 | 实际效果 |
|---|---|---|
langs |
c("r", "python", "bash") |
为每种代码/shell 语言选择内置规则 |
patterns |
NULL |
具名正则规则;名字与内置规则同名会替换该规则,新名字会追加。宿主要用文件管理黑名单,自己读文件成具名向量传进来即可 |
include_defaults |
TRUE |
包含内置的按语言分组规则集(.DATA_SHIELD_INGRESS_RULES):序列化/编码、pandas/R
写文件、网络传输(含
nc/scp//dev/tcp)、数据文件显示、受保护名称预览 |
on_fail |
"block" |
block:拒绝该工具调用;ask:强制走现有权限审批
UI/回调 |
ignore_case |
TRUE |
大小写不敏感 |
Ingress 在通常的读/写/执行能力快速路径之前扫描所有工具参数,包括未知 工具和只读工具。它不禁止普通读取:默认规则聚焦于高置信度的”读取并显示”、 序列化、编码、网络传输模式。它是廉价的预筛,因为代码可以被混淆,所以 egress 扫描才是主边界。
shield_tool_policy() —— 按工具精确名/glob
的信任与拒绝规则
| 设置 | 含义 |
|---|---|
default="scan" |
每个工具默认都扫描,除非有规则覆盖 |
execution="deny" |
执行前直接拒绝该工具 |
ingress="bypass" |
跳过盾的参数扫描,但权限门仍然生效 |
egress="bypass" |
该工具的输出不经盾过滤直接返回;每次 bypass 都会审计 |
egress="deny" |
把结果替换成一句明确的”策略拒绝”提示 |
规则支持精确名和 * glob。精确匹配优先;否则第一个匹配的
glob 生效。例如, 当开发者能保证 KMPlot 的所有输出都对 LLM
安全时,可以让它 bypass egress; 而 btw_tool_docs_*
可以拿到一条更宽的信任规则。这条策略永远不会绕过
codeagent 独立的权限系统。
shield_sandbox() —— 失败关闭的便携路径策略
| 参数 | 默认值 | 实际效果 |
|---|---|---|
project_root |
getwd() |
路径策略允许的项目根目录 |
protected_paths |
无 | 额外注册的数据根目录;匹配最长的根目录决定模式 |
temp_root |
新建的 session 临时目录 | 隔离的临时根目录 |
modes |
项目 rwx、数据 rw、临时
rwx
|
逻辑上的盾能力(不是 chmod 位) |
process_exec |
TRUE |
允许继承同一盾的 Agent/AuditCode;所有非委派 exec 工具仍要求 OS backend |
network |
"tool_policy" |
交给工具策略决定;"deny" 直接拦网络能力 |
symlink_escape |
"deny" |
解析真实路径,拒绝逃逸出允许根目录的软链接 |
backend |
"auto" |
policy、auto、或
required
|
on_unavailable |
"policy" |
完整 OS 适配器不可用时降级为策略;block 对 exec/net
严格拒绝 |
当前实现是便携式中央门路径/能力策略,不是内核级隔离。它只放行能解析
到配置根目录的非 exec 路径操作。所有非委派 exec 工具(包括 Bash、RunR、
ExploreData 和 Lint)都会失败关闭:路径 metadata
无法约束代码字符串、子进程、 网络访问或 .lintr
这类可执行项目配置。未来完整适配器必须把这些工具放入 真正的 OS
沙箱。
shield_reviewer() —— 可选的脱敏代码语义审查
| 参数 | 默认值 | 实际效果 |
|---|---|---|
client_factory |
NULL |
可选的函数,返回一个全新的独立 ellmer Chat |
model |
CODEAGENT_FAST_MODEL |
审查模型;未配置时按 on_error
处理,绝不静默回退主模型 |
scope |
exec/write/net | 只有这些工具能力才产生审查开销 |
on_risk |
"ask" |
风险分类结果变成 ask 或 block |
on_error |
"ask" |
模型缺失、超时、请求/JSON 错误都变成 ask 或 block;无审批通道则 block |
backend |
"remote_sanitized" |
远程只看 regex/value 脱敏后的代码;也支持
"local_only",但必须显式提供本地
client_factory,缺失时 fail closed |
timeout |
30 |
异步审查超时秒数 |
审查器不是一个工具,主模型无法跳过它。它没有工具、没有历史记录;代码被标记为
不可信数据,输出按固定
JSON(risk、confidence、reason)解析。确定性的
ingress 规则先跑,所以已经被拦下的调用不产生模型开销。
DataShield$new() 直接生命周期管理
strategies = NULL
时,构造函数直接参数(max_rows、distributions、
k_anon、category_max、category_ratio、audit_max、dp_epsilon、
dp_budget)会创建默认的 DescribeData + 核心 egress
配置。audit_max 默认 1000 条非敏感决策事件; 设为
0 禁用记录。传 strategies = list(...)
只会启用列出的策略。 列表顺序控制 egress 扫描器
pipeline;ingress、reviewer、sandbox 和 tool-policy
策略在各自独立阶段运行。动态/session 拥有的工作流用
shield$register_data()、
$install()、$describe()、$audit()、$clear_audit()、$clear()、$close()。
通俗术语表
| 术语 | 通俗含义 |
|---|---|
| ingress | 工具调用的名字/参数进入本地执行的那一刻;工具运行前扫描 |
| egress | 内容离开本地工具、即将进入 LLM 的那一刻 |
| row-cap | 打印表格行数的上限;0 表示不放行任何原始行 |
| value-match | 对照已注册受保护数据索引出的高熵值做精确匹配 |
| PII | 个人可识别信息,如邮箱、电话、身份证号、姓名 |
| kind | 一份已注册资产是什么(dataset/spec/document/synthetic),不是它的 R 数据类型或访问级别 |
| provenance | 可验证的来源标签,证明某个结果来自哪份已注册资产 |
| raw access | 内容可以不受行/值限制地进入某条 LLM 边;仍可能应用可选的 secret/PII 扫描 |
| regex | 正则表达式:如 STUDY-[0-9]+ 这样的文本模式 |
| PCRE | Perl 兼容正则表达式,R 用 perl=TRUE
时使用的正则语法 |
| span | 检测到的敏感子串的起止字符位置,用于精确替换 |
| k-anonymity threshold | 除非至少 k 行支持,否则不暴露某个类别标签 |
| fail closed | 安全扫描器出错时,默认拦截输出而非放行 |
| semantic reviewer | 一个独立的小模型,用来分类脱敏后的工具代码想做什么;它绝不会远程看到原始数据 |
| R6 | R 的可变对象系统;一个 DataShield
持有私有的数据集/索引/生命周期 |
非敏感审计日志
shield$audit() 返回一个内存中的策略决策 data.frame:
| 字段 | 含义 |
|---|---|
timestamp |
UTC 事件时间 |
edge |
策略边界,包括
prompt、ingress、egress、response
或 describe
|
tool_name, tool_call_id
|
非敏感的关联标识符 |
strategy |
包括
row_cap、value_match、regex、ingress、dp_budget、tool_policy、asset_policy、sandbox,或自定义
scanner 名 |
action, reason
|
如
redact、block、ask、consume、exhausted、bypass、deny
等策略动作及规则/原因标签 |
match_count, score
|
命中数量和归一化风险分数 |
它绝不存储原始工具输入/输出、命中的值、数据行、span
文本、或哈希值。 audit_max
限制内存(最旧的事件会被丢弃);用 shield$clear_audit()
清空。 每个 DataShield R6 都有自己的日志,所以
session/thread 隔离与策略实例保持一致。
recent <- shield$audit(limit=100)
shield$clear_audit()
数据资产策略:资产是什么 × LLM 能看到多少
资产的内容类型和 LLM 访问级别是正交的两个轴:
kind |
默认 prompt | 默认 egress | 典型用途 |
|---|---|---|---|
dataset |
schema |
scan |
患者/分析数据 |
spec |
raw |
scan |
ADaM spec、SDTMIG、公开字典 |
synthetic |
raw |
scan |
dummy/边界情况测试数据 |
document |
scan |
scan |
普通参考文档 |
| 访问级别 | 含义 |
|---|---|
none |
该 LLM 边完全看不到内容 |
schema |
只给严格 DescribeData 风格的元数据 |
scan |
内容必须经过已配置的盾扫描器 |
raw |
绕过行/值限制;除非显式关闭,否则仍跑基础 secret/PII 正则 |
shield$register_asset(
  adam_spec,
  name = "adam_spec",
  kind = "spec",
  llm_access = list(prompt = "raw", egress = "scan"),
  scan_secrets = TRUE,
  reason = "Validated public specification",
  expires = "session"
)

prompt_text <- shield$prompt_content("adam_spec")
Raw egress 不会仅凭 kind
就自动放行,它需要显式策略 + 来源凭证(provenance):
shield$register_asset(
  adam_spec, name = "adam_spec", kind = "spec",
  llm_access = list(prompt = "raw", egress = "raw"),
  reason = "Validated public specification")

tool_result <- shield$trusted_result(value, source = "adam_spec")
未打标签或混合内容的工具结果仍会被扫描。Raw 资产策略必须填
reason,默认 随所属 DataShield 的 session 过期,可设置
POSIXct 过期时间,且每次都会产生 bypass 审计事件。Synthetic 的 raw
始终保留基础 PII/secret 扫描;spec 的 raw 可以显式设置
scan_secrets = FALSE。
列级 raw 访问
资产是整份对象级别的;register_data(column_access=)
是列粒度的对应机制,
用于一个大部分受保护、但含少量公开字典列(例如 SDTM 的
TESTCD 代码表)的 data.frame。它复用与资产相同的
none/schema/scan/raw
访问级别,拆成 prompt/egress 两个 scope,raw
边同样要求非空的 reason。
shield$register_data(
  vs, name = "vs",
  sensitivity   = c(SUBJID = "identifier", TESTCD = "identifier"),
  column_access = list(
    TESTCD = list(prompt = "raw", egress = "raw",
reason = "SDTM public codelist", scan_secrets = TRUE)))-
prompt = "raw"让DescribeData枚举该列的真实值(不做 k-匿名抑制), 这样模型才能写出正确的过滤条件。 -
egress = "raw"把该列从 value-match 索引中移除,所以它的值不会从工具 输出中被扣留。 - 缺少
reason的 raw override 是硬错误(register_data()拒绝整个 dataset),因此标错的 raw 授权不会被忽略。coverage()$raw_access_columns统计当前生效的 override 数量。
egress 分档注意事项: 仅在 EGRESS 侧,
none(任何该列值命中时拒绝 整个工具结果)和raw(从 value-match 索引移除)目前有独立行为;schema与scan都走普通 value-match 扫描,尚没有结构化的 schema/scan egress 差异。列级scan_secrets控制的是 PROMPT 侧的 rawDescribeData路径, 不是 egress。完整的列级 egress 分档需要结果到列的 provenance;PROMPT 侧已经实现全部四个级别。
宿主模式:一个自带来源标记的 spec 工具
Raw 资产的 egress 需要来源凭证。与其在框架里造一个”trusted
tool”类型, 不如让宿主用现成的原语——register_asset() 加
trusted_result()——自己 拼一个工具:
read_adam_spec_tool <- function(shield) {
  ellmer::tool(
    name = "ReadADaMSpec",
    fun = function(path) {
      text <- readLines(path, warn = FALSE)
      shield$trusted_result(paste(text, collapse = "\n"), source = "adam_spec")
    },
    description = "Read a registered, LLM-safe ADaM specification.",
    arguments = list(path = ellmer::type_string("Spec file path")))
}
# 只需注册资产策略一次;工具每次读取都会自动打上来源标记
shield$register_asset(adam_spec_path, name = "adam_spec", kind = "spec",
  llm_access = list(prompt = "raw", egress = "raw"),
  reason = "Validated public specification")
# 另外,把工具本身挂到 chat 上,模型才能调用它;然后(重新)install
# 一次,egress 包裹层才能读到 trusted_result() 打的来源标记
chat$register_tool(read_adam_spec_tool(shield))
shield$install(chat)
Agent 像调用任何普通工具一样调用 ReadADaMSpec;raw
放行由已注册的资产策略
授权并被审计,而任何其他工具返回的混合/未打标签结果仍会被扫描。
P0 —— 地基(现已可用)
已经能提供真实保护的最小确定性切片:
# 简单入口:策略 spec 会为这个 client 创建一个私有 DataShield R6。
client <- codeagent_client(chat, data_shield = list(
  shield_describe(k_anon = 5),

  shield_egress(max_rows = 0)
))

# 仅 harness 场景:先挂工具,再安装它的 R6 引擎。
client <- codeagent_client(chat, register_tools = FALSE,
  data_shield = list(shield_describe(), shield_egress(max_rows = 0)))
chat$register_tool(my_tool)
client$data_shield$install(client$chat)-
边 2 —— 基于形状的 egress 行数上限。 codeagent
不检查代码,也不拦
print本身。它只看工具返回文本的形状:具有 data.frame/tibble 打印 签名或多行矩形表格的输出,会被截断成一句形状摘要;标量、消息、模型摘要、 图表和错误信息原样放行。与内容无关,可通过max_rows调节。 -
边 1 —— ambient 注入保持仅 schema。 codeagent 的
ambient 注入本来就只 给出
name [data.frame N x M: col:type, ...](不给值);数据盾保持这个不变。
Shiny 中的运行时上传
数据集不需要在 app 启动时就已知。在上传的 observer 里,读完文件后立刻 注册即可;工具可能已经挂好并被包裹了,因为 value matching 在每次调用时 读取的是活的索引。
# 每个 Shiny server session 内部:一个 R6 可以被选定的多个 chat 共享。
shield <- DataShield$new(
  strategies = list(shield_describe(), shield_egress(max_rows = 0)))
data_env <- new.env(parent = emptyenv())

client_factory <- function() {
  codeagent_client(make_chat(), data_shield = shield)
}

observeEvent(input$file, {
  df <- read.csv(input$file$datapath)
  data_env$uploaded <- df
  shield$register_data(df, name = "uploaded") # 无需预先知道列
})
一个完整可运行的宿主风格 Shiny 示例安装在:
system.file("examples/data_shield_upload_app.R", package = "codeagent")从开发检出目录:
它演示了上传后的五种结果:整批行被 row_cap
扣留、单个已索引值被 value_match 扣留、未注册 PII 被
shield_regex 脱敏、无害的形状摘要 正常放行、以及严格
DescribeData 元数据抑制了原始标识符。
若要一个更小、聚焦单一场景的演示——一个真实的
codeagent_client 接进一个 真实的
shinychat::chat_ui,一侧是 fileInput()
上传,另一侧是实时的 非敏感审计日志——见
inst/examples/data_shield_minimal_app.R。
多用户隔离: 在 Shiny server 函数内部创建
DataShield$new(), 只在目标 chat 线程之间共享它,并通过shield$register_data()注册数据。 其他浏览器 session 会拿到各自独立的 R6 实例,看不到也影响不了这个索引。
P0 行数上限的直观行为(已实现):
| 工具输出 | P0 动作 |
|---|---|
print(mtcars)(整批行) |
截断 → 形状摘要 |
tibble 打印(# A tibble: 320 x 12) |
截断 |
print(nrow(df)) → 320
|
放行 |
| 一条状态消息 | 放行 |
print(summary(fit)) |
放行(不是行数据) |
P1 DescribeData:严格安全元数据契约
DescribeData
是模型理解受保护数据、但不接收行的唯一合法途径。它的输出
由三个正交维度共同决定:
| 维度 | 取值 | 目的 |
|---|---|---|
| 全局策略 | distributions = "off" / "on" / "dp" |
严格默认不给分布;on 是显式 opt-in;dp
加噪声 + 预算 |
| 列敏感度 | identifier / quasi / measure / open |
钳制该列最大披露程度的业务角色 |
| 数据类型 | numeric / factor / character / Date / … | 决定安全表示形式:范围、标签、还是自由文本标记 |
严格模式(distributions = "off")矩阵:
| 元数据 | identifier / quasi | measure / open |
|---|---|---|
| 列名、类型、是否缺失 | 显示 | 显示 |
| 数值/日期 min-max | 隐藏 | 显示 |
| 低基数分类标签 | 隐藏 | 显示但不给计数;支持行数 < k 的水平被抑制 |
| 真实自由文本示例 | 隐藏 | 隐藏 |
| 直方图、分位数、均值/标准差、类别计数 | 隐藏 | 隐藏(仅 on/dp opt-in) |
factor 类型不代表自动安全:一个被 factor 化的受试者 ID 仍然是
identifier。 字符列只有在低基数、低唯一性、非
PII、且每个暴露的水平都满足 k-匿名阈值时,
才会给出分类标签。自由文本在严格模式下永远不给真实示例。
System prompt 中的受保护 schema
如果受保护数据在构建 codeagent_client()
之前已经注册,经过过滤的 DescribeData 风格
schema 会进入 system prompt 的 <protected-data>
区块。 模型因此能知道真实的 dataset
名、维度和允许使用的列,但看不到标识符值或稀有
类别。DescribeData 仍是权威的实时查询后备。
register_data()
会更新实时引擎和值索引,但刻意不会重写已有 Chat 的 prompt。
运行时上传后要显式刷新:
shield$register_data(df, name = "uploaded")
client <- refresh_data_shield_context(client)
刷新会重建 prompt,同时保留历史、工具、预算、hooks 和同一个实时
DataShield; 代价是一次 prompt cache miss。在
distributions = "dp" 下,生成 schema block 和调用
DescribeData 都会消耗配置的每 dataset 隐私预算。
P1.5 有序 egress 扫描器
策略列表的顺序就是执行顺序。即使没有注册任何
data.frame,shield_regex() 也能抓到敏感内容:
client <- codeagent_client(chat, data_shield=list(
  shield_egress(max_rows=0),
  shield_regex(on_fail="redact"),
  shield_regex(patterns=c(study_id="STUDY-[0-9]+"),
               include_defaults=FALSE, on_fail="block")
))
内置规则覆盖 email、类电话号码字符串、常见 API-token 前缀、18
位身份证号 形状。redact
只替换命中的片段;block 丢弃整个面向模型的结果。可以用
shield$add_scanner(name, fn) 追加自定义 scanner
函数;非法的 scanner 结果/错误会 fail closed。
C2 通用 ingress 扫描
shield_ingress() 被安装进 codeagent
现有的唯一中央权限门,不会创建
一个与之竞争的回调/门。它在只读快速路径之前扫描每个工具的参数。block
结果会抛出 tool_reject;ask 结果复用当前
CLI/Shiny 的审批回调, 包括 tool-call id 的关联。
client <- codeagent_client(chat, data_shield=list(
  shield_ingress(on_fail="ask"),
  shield_egress(max_rows=0),
  shield_regex()
))
默认规则刻意不会拒绝每一次 Read 或
print:nrow(study) 和
print("done") 会放行,而
head(study)、dput(study)、 base64/pickle/JSON
序列化、上传风格的 curl/requests 调用、shell 里显示
数据文件,都会被审查或拦截。
C5 便携式沙箱与 btw 边界
shield_sandbox() 保留可验证路径的非 exec
编码操作:项目目录和 session 临时 目录默认
rwx,受保护数据默认
rw。便携式后端会拦截允许根目录之外的路径并
拒绝符号链接逃逸;由于路径 metadata
无法约束代码或可执行项目配置,所有非委派 exec 工具(包括
Bash、RunR、ExploreData 和 Lint)都会失败关闭,继承同一盾的
Agent/AuditCode 仍可使用。
btw 不被假定提供 OS 级隔离。它的文件工具用
fs::path_has_parent() 强制限定
cwd,但我们的探测发现一个项目内指向外部文件的符号链接能够通过; 它的
RunR 在全局环境里通过 evaluate 执行,只恢复
cwd/options/环境变量。 因此数据盾对 native、btw、MCP
和宿主工具一视同仁地生效。
C4 语义审查器
shield_reviewer() 对确定性 ingress
规则起补充作用,用于间接别名、多步
序列化、以及混淆过的”数据来源到去处”意图。远程审查器只收到脱敏后的代码
和非值元数据。每次审查都会创建一个全新的独立 Chat,无工具、无历史记录。
默认工厂使用父级 provider 加 CODEAGENT_FAST_MODEL;显式
client_factory
可以提供本地或专用的审查器。缺失/失败/非法的审查器结果都按
on_error 处理;无审批通道时 ask 会退化为 block。
相关数据工具及其边界
-
DescribeData只在启用shield_describe()时注册(或直接构造函数使用 默认策略时注册)。它返回上面的过滤后元数据契约,也能看到之后注册的数据集。 -
ExploreData是执行任意 R 的数据查询工具,不是只读工具、保密边界或 OS 沙箱。 它在子环境中执行传入的 R 代码;数据盾开启时,其参数仍经过中央 ingress gate, 面向模型的结果仍经过 egress 过滤。data.frame 结果只向模型给出 shape 字符串, 丰富的行数据留在 UI artifact 中;标量文本仍可被value_match/regex 命中。 -
audit_code_tool(shield, project_root)是宿主可在执行 R 代码前选择注册的AuditCode工具。它解析静态引用,只读取project_root内扩展名获准的普通 source 文件,从不执行提交的代码,并返回风险/引用元数据而不是文件内容。盾 开启时,白名单内的 source 文本还会经过 reviewer rail。AuditCode不向主模型 授予 read/write/shell 能力。
路线图
-
P0.5 ——
value_match(已实现):通过对照用shield$register_data()注册的高熵值匹配工具输出,确定性地抓住行数 上限漏过的定点泄漏(例如只 print 一个病人的名字)。 -
P1 ——
DescribeData+ 受保护数据注册表(严格模式已实现):模型的 经批准的强化视图(schema、敏感度、是否缺失、measure/open 的范围和 满足 k-支持的标签;严格"off"模式下不给分布/计数/示例)。distributions="on"/"dp"(类别计数,真实值或按 dataset 记账的 DP 加噪值)已实现;数值/连续统计量的 DP 仍是后续阶段(需要宿主提供 不依赖数据本身的裁剪边界)。 -
P1.5 —— 有序 scanner 管道 +
shield_regex()(已实现):未注册的 PII/密钥会被精确定位并脱敏/拦截;自定义 scanner 失败会 fail closed。 -
C2 ——
shield_ingress()(已实现):所有工具参数都经过中央权限门; 确定性的高置信度规则会拦截或强制审批。 -
C5 —— 便携式
shield_sandbox()(已实现):项目/临时目录默认rwx,受保护数据默认rw,具备 realpath/符号链接容纳,并对无法约束的 exec 失败关闭;完整 OS 进程适配器仍是路线图项。 -
C4 ——
shield_reviewer()(已实现):可选的脱敏 ingress 代码语义 审查,使用一个全新的小模型 Chat;远程 raw 输出仍被禁止。 - P2 —— 完整 OS 沙箱适配器,以及数值/连续统计量的差分隐私(opt-in)。
子代理边界
前台子代理(Agent)继承完全同一个实时
DataShield R6;在第一次子模型
请求之前,其工具已经安装在同一套中央权限门和 Shield gate
后面。这对同步和 并发异步 Agent
调用都适用。盾激活时,不会暴露无法接收该引擎的原始
btw_tool_agent_*/自定义委派路径。子代理回复会在进入
SubagentStop hook、 callback 或父级工具结果之前先经过
output gate,且受盾保护的 sidechain 不持久化。
BackgroundAgent 和 /bg 在数据盾开启时目前会
fail closed:它们的 mirai worker 是一个独立的 R
进程,无法安全地共享 session 的 R6 状态或
受保护值索引。在实现按所有者重建 worker 的协议之前,请使用前台
Agent。
排列组合安全性:每种组合到底能防住什么
数据盾由独立策略组合而成,所以有可能启用一种看起来有保护、实际上没有
的组合。下表直接来自
tests/testthat/test-data-shield-combinations.R (这是一个
CI 测试套件,不是一段描述性文字):未来任何破坏这些结论的重构
会立刻让这个测试套件失败,而不是悄悄过时。
| 组合 | 整批数据泄漏 | 定点单值泄漏 | 别名绕过(y <- study; print(y)) |
结论 |
|---|---|---|---|---|
只开 shield_egress()
|
挡住 | 挡住 | 挡住(egress 检查的是输出内容,不是代码路径) | ✅ 安全底线 |
egress + ingress +
regex(推荐) |
挡住 | 挡住 | 挡住 | ✅ 推荐配置 |
只开 shield_ingress() |
泄漏 | 泄漏 | 泄漏(已实测确认) | ⚠️ 单独使用不安全 |
只开 shield_describe() |
泄漏 | 泄漏 | — | ⚠️ 单独使用不安全(只管理模型自己的元数据查询,不过滤其他工具的输出) |
只开 shield_regex()
|
— | 非 PII 形状的自定义 ID 会泄漏 | — | ⚠️ 只能挡住常见 PII 形状 |
一句话结论:shield_egress()
是唯一不可省的边界。其余所有策略都是纵深 防御,不能替代它。
三个可以直接用的组合模板
shield_preset_strict()、shield_preset_balanced()、shield_preset_clinical()
是可直接调用的函数,返回下面这些确切组合——不用复制粘贴:
# 严格:合规/审计演示场景
strict <- shield_preset_strict()
# shield_describe(k_anon = 5),
# shield_egress(detectors = c("row_cap", "value_match"), max_rows = 0, on_fail = "block"),
# shield_regex(on_fail = "block"),
# shield_ingress(on_fail = "block")

# 均衡:日常开发,摩擦小
balanced <- shield_preset_balanced()
# shield_egress(max_rows = 0, on_fail = "redact"),
# shield_regex(on_fail = "redact")

# 临床:加语义审查器 + 严格 k-匿名
clinical <- shield_preset_clinical()
# shield_describe(k_anon = 5),
# shield_egress(max_rows = 0),
# shield_regex(),
# shield_ingress(on_fail = "ask"),
# shield_reviewer(model = Sys.getenv("CODEAGENT_FAST_MODEL"), on_risk = "ask")

client <- codeagent_client(chat, data_shield = shield_preset_strict())
两个刻意不安全的演示组合
这两个组合复现了上面矩阵表里”单独使用不安全”的两行,和
inst/examples/data_shield_minimal_app.R 的”Shield
strength”选择器里接线的 代码完全一致——在 demo
里切到其中一个,问聊天”dump the uploaded data”, 亲眼看它当场泄漏。
# 不安全:只开 ingress —— 完全没有 egress 边界。
unsafe_ingress_only <- list(shield_ingress(on_fail = "block"))

# 不安全:只开 describe —— DescribeData 注册了,但没有任何东西过滤
# 其他工具返回的内容。
unsafe_describe_only <- list(shield_describe(k_anon = 3))-
unsafe_ingress_only只在工具执行前扫描参数(见前面参数参考里的shield_ingress())。它没有shield_egress(),所以没有任何东西检查 工具实际返回了什么。它的静态正则规则也只看代码字面文本:y <- study; print(y)匹配不上任何”打印/dump 已知数据集名”的模式, 别名就这样溜过去了——这正是上面矩阵表里标记”已实测确认”的那个绕过。 -
unsafe_describe_only只注册了DescribeData工具(见前面的shield_describe())。那个工具是模型自己经批准的查询通道;它不管 其他工具的返回值,所以一个简单返回原始 data.frame 的工具完全不受影响。 - 两者都没有
shield_egress()——为什么这一个策略是所有其他组合都依赖的 基础,见上面的”排列组合安全性”。
inst/examples/data_shield_minimal_app.R
提供一个实时的”Shield strength”
(盾的强度)下拉选择器,涵盖以上三个模板加这两个刻意不安全的组合,可以在
运行中的聊天里对这五种全部实时切换,亲眼看到上表里的具体泄漏当场发生。
诚实的局限性
数据盾降低披露风险,但不能消除它。确定性检测器(行数上限、
value_match、正则)会漏掉对抗式混淆的 egress(例如先把数据
base64 编码再打印);这些情况靠 ingress
黑名单和无网络沙箱来缓解——而不是
彻底解决。最强的保证来自结构性层面(只喂元数据 + 无网络执行),扫描
只是纵深防御。
依赖它之前需要权衡的具体残余风险:
-
层组合很重要——见上面的排列组合安全表。 只开
shield_ingress()或只开shield_describe()、不开shield_egress(),不是安全配置。 不要省略 egress。 -
语义审查器本身就是一个 LLM。
shield_reviewer()可能被足够混淆的 “数据来源到去处”路径绕过,且每次审查都增加延迟/成本;它是确定性防线 之上的纵深防御,不是保证。 -
value_match线性增长,现已有上限。 在开源 {pharmaverse} 项目的 CDISC-ADaM 格式示例数据上做过 benchmark(inst/bench/value_match_benchmark.R): 索引 100 万个高熵值约需 130 MB 内存、约 10 秒构建时间,对普通临床文本 零误报,pharmaverse 格式的USUBJID/SUBJID均能命中。由于内存线性增长,register_data(max_index_values=)给索引设了上限(默认 50 万,约 65 MB)。 如果该上限会截断索引,注册会报错并拒绝这个部分索引的数据集;应提高上限、 拆分数据,或显式使用NULL/Inf。min_len/min_card阈值在这些 ID 上 表现良好,未做调整。 - 图片工具结果和完整 OS 隔离仍是路线图项(见文首状态横幅):工具返回的 原始行渲染表格/图表会绕过文本 egress 扫描,便携式沙箱是路径/能力策略, 不是内核级隔离。Prompt 图片 OCR 是上文所述、单独选择启用的边 1 控制; 可选依赖缺失时的 pass 降级是一个明确记录的盲区。
-
shinychat含文本附件会在边 1 扫描。 codeagent 主 UI 启用了chat_ui(allow_attachments = TRUE);input gate 会提取并扫描含文本附件 (例如ContentPDF),无法验证内容时 fail closed 到 block(不可变 Content 不能原地脱敏)。图片附件仍是盲区,除非接入 OCR scanner (data_shield_ocr_scanner());scanner 已配置时,OCR 或扫描失败会 fail closed 到 block。fileInput()→register_data()仍是表格上传的受控、建索引路径。 -
数据盾不管破坏性操作(
rm -rf、删表、强制推送)——这是另一个维度 (操作安全,不是数据保密),由权限门和 hooks 管,不归本文档任何shield_*()策略管。shield_ingress()的模式匹配管道可以被借用来 做这件事,但它的内置默认规则聚焦于数据外泄,不是破坏性操作。具体机制 (rulesdeny glob、PreToolUsehook、自定义shield_ingress()规则) 以及为什么它们都防不住换种写法,见vignette("permissions")(英文版)的”Hooks”节。